

Penulis: Keisha Sophia Zahra (2501833), Nailah Ramadhani (2502838), dan Yani Audistia (2503285)
Editor: Nendeh Rizka Nurfadilah (2508823)
PENDAHULUAN
Jawaban instan dari kecerdasan buatan (AI) sering terasa ringan dan tanpa biaya, padahal setiap jawaban berjalan di atas infrastruktur fisik yang membutuhkan air. Penggunaan air tersebut tersebar dalam tiga lingkup, yaitu air untuk mendinginkan server di pusat data, air yang dipakai pembangkit listrik untuk memasok energinya, dan air yang tertanam dalam rantai pasok seperti pembuatan cip (Li et al., 2025). Laporan Laboratorium Nasional Lawrence Berkeley memperkirakan bahwa pusat data di Amerika Serikat mengonsumsi langsung sekitar 66 miliar liter air pada 2023 (Shehabi et al., 2024). Angka ini menunjukkan bahwa pendinginan fasilitas komputasi telah menjadi pengguna air yang tidak dapat diabaikan, sementara permintaan listrik pusat data diperkirakan meningkat tajam hingga 2028 sehingga berpotensi menambah jejak air tidak langsung dari AI (Shehabi et al., 2024).
Skala persoalan menjadi lebih jelas ketika melihat kebutuhan air untuk melatih model bahasa berukuran besar. Pelatihan GPT-3 di pusat data Microsoft di Amerika Serikat diperkirakan dapat menguapkan langsung sekitar 700.000 liter air bersih, dan permintaan AI global diproyeksikan menyebabkan penarikan air sebesar 4,2 hingga 6,6 miliar meter kubik pada 2027 (Li et al., 2025). Besarnya kebutuhan tersebut tidak seragam karena efisiensi air AI bergantung pada ruang dan waktu, termasuk suhu dan kelembapan udara luar ruangan yang memengaruhi efisiensi pendinginan server (Li et al., 2025). Kondisi ini relevan bagi Indonesia, sebab pusat data di Jakarta dan Batam berada di dataran rendah yang panas dan lembap sehingga mengandalkan pendingin mekanis berenergi besar, dan kedua wilayah tersebut juga menghadapi persoalan pasokan air (Tasyarani, 2026). Para pakar bahkan menilai bahwa fasilitas baru sebaiknya dibangun di wilayah yang lebih kaya air (Ho, 2026).
Di sisi lain, hubungan antara AI dan air tidak hanya berupa konsumsi, karena teknologi yang sama turut membantu manusia memahami dan mengelola air. Pembelajaran mendalam telah diterapkan di bidang hidrologi dan sumber daya air, antara lain untuk prakiraan banjir, kualitas air, dan debit sungai (Sit et al., 2020), sehingga para ahli hidrologi mengkaji ulang peran ilmu hidrologi di era pembelajaran mesin (Nearing et al., 2021). Pembelajaran mesin juga dipetakan memiliki potensi kontribusi pada upaya mitigasi dan adaptasi perubahan iklim di berbagai sektor (Rolnick et al., 2022). Namun, manfaat tersebut tidak otomatis berkelanjutan apabila jejak lingkungan dari sistem AI sendiri tidak dikelola, sehingga jejak air perlu ditangani bersama jejak karbon (Li et al., 2025). Oleh karena itu, artikel ini membahas hubungan ganda antara AI dan air, yaitu sebagai pengguna sekaligus penolong dalam pengelolaan air, dengan perhatian pada konteks Indonesia.
PEMBAHASAN
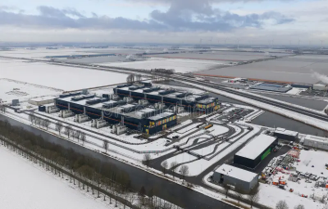
Jawaban instan dari kecerdasan buatan (AI) terasa ringan dan tanpa biaya, padahal setiap jawaban berjalan di atas infrastruktur fisik yang membutuhkan air. Penggunaan air tersebut tersebar dalam tiga lingkup, yaitu air untuk mendinginkan server di pusat data, air yang dipakai pembangkit listrik untuk memasok energinya, dan air yang tertanam dalam rantai pasok seperti pembuatan cip (Li et al., 2025). Perlu dibedakan pula antara penarikan air dan konsumsi air, sebab konsumsi merujuk pada air yang menguap dan tidak langsung kembali ke sumbernya. Laporan Laboratorium Nasional Lawrence Berkeley memperkirakan bahwa pusat data di Amerika Serikat mengonsumsi langsung sekitar 66 miliar liter air pada 2023 (Shehabi et al., 2024). Angka ini memperlihatkan bahwa pendinginan fasilitas komputasi telah menjadi pengguna air yang tidak bisa diabaikan meskipun porsinya terhadap total penggunaan air nasional relatif kecil.
Skala persoalan menjadi lebih jelas ketika melihat kebutuhan air untuk melatih model bahasa berukuran besar. Pelatihan GPT-3 di pusat data Microsoft di Amerika Serikat diperkirakan dapat menguapkan langsung sekitar 700.000 liter air bersih (Li et al., 2025). Penggunaan model sehari-hari oleh jutaan pengguna masih menambah konsumsi tersebut secara terus-menerus. Permintaan AI global bahkan diproyeksikan menyebabkan penarikan air sebesar 4,2 hingga 6,6 miliar meter kubik pada 2027 (Li et al., 2025). Besaran itu melampaui total penarikan air tahunan beberapa negara seperti Denmark sehingga isu ini layak masuk agenda kebijakan.
Gambar diambil dari fr.dreamstime.com
Besarnya air yang dibutuhkan ternyata tidak seragam karena efisiensi air AI sangat bergantung pada ruang dan waktu. Bauran sumber listrik dan teknologi pendingin membuat jumlah air per unit komputasi berbeda antarwilayah dan antarjam (Li et al., 2025). Perbedaan ini membuka peluang penjadwalan beban kerja, misalnya memindahkan pelatihan model ke waktu atau lokasi yang lebih hemat air. Permintaan listrik pusat data pada skenario laporan Lawrence Berkeley diperkirakan meningkat tajam hingga 2028 (Shehabi et al., 2024). Kenaikan itu berpotensi menambah jejak air tidak langsung dari AI karena pembangkitan listrik juga membutuhkan air.
Iklim menjadi salah satu faktor yang paling menentukan perbedaan tersebut. Suhu dan kelembapan udara luar ruangan ikut menentukan seberapa efisien air dipakai untuk mendinginkan server (Li et al., 2025). Pusat data di Jakarta dan Batam berada di dataran rendah yang panas dan lembap sehingga harus mengandalkan pendingin mekanis berenergi besar dengan beban tinggi sepanjang tahun, yang berdampak pada nilai PUE yang lebih tinggi, konsumsi air yang lebih besar, dan jejak karbon operasional yang lebih besar (Tasyarani, 2026). Iklim tropis tidak mengenal musim dingin yang dapat dimanfaatkan untuk pendinginan alami sehingga pilihan teknologi pendingin menjadi penentu utama besarnya konsumsi air. Sistem berpendingin udara memakai air jauh lebih sedikit daripada menara pendingin tetapi umumnya membutuhkan listrik lebih banyak sehingga selalu ada pertukaran antara hemat air dan hemat energi.
Kondisi hidrologi menentukan apakah kebutuhan air tersebut dapat dipenuhi tanpa mengganggu pasokan lain, dan ketersediaan air tanah maupun air permukaan sangat berbeda antardaerah di Indonesia. Pusat data di Indonesia terkonsentrasi di kawasan Jabodetabek dan Batam, dua wilayah yang sama-sama menghadapi persoalan pasokan air, dan Jakarta bahkan bergantung pada air tanah yang berisiko memicu penurunan muka tanah (Tasyarani, 2026). Pakar air menilai fasilitas baru sebaiknya dibangun di wilayah yang lebih kaya air, misalnya sekitar Nusantara dan Samarinda yang dilalui Sungai Mahakam, sedangkan air baku Batam sebagian besar berasal dari air permukaan seperti air hujan dan waduk (Ho, 2026). Air jauh lebih sulit dan mahal dipindahkan antarwilayah dibandingkan listrik atau data sehingga ketersediaan air lokal seharusnya menjadi pertimbangan awal pemilihan lokasi. Kebutuhan air pusat data berpotensi bersaing dengan kebutuhan dasar masyarakat dan sektor lain di sekitarnya apabila pertimbangan hidrologis diabaikan.
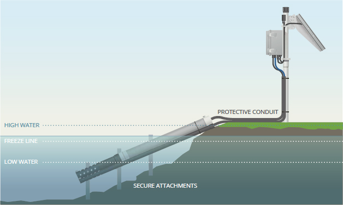
Hubungan AI dan air ternyata tidak hanya berupa konsumsi karena teknologi yang sama juga membantu manusia memahami dan mengelola air. Tinjauan terhadap penerapan pembelajaran mendalam di bidang hidrologi dan sumber daya air memperlihatkan pemanfaatannya untuk prakiraan banjir, kualitas air, dan debit sungai (Sit et al., 2020). Model ini bekerja dengan mempelajari pola dari data historis berukuran besar sehingga mampu menangkap hubungan nonlinear yang sulit dirumuskan secara fisik. Perkembangan tersebut mendorong para ahli hidrologi mengkaji ulang peran ilmu hidrologi di era pembelajaran mesin, terutama dalam prediksi aliran sungai (Nearing et al., 2021). Manfaat itu berpotensi besar bagi pengelolaan air asalkan biaya air dari komputasinya turut diperhitungkan.
Gambar diambil dari fondriest.com
Gambaran tersebut menunjukkan bahwa hubungan AI dan air bersifat ganda, yaitu sebagai pengguna sekaligus penolong. Pembelajaran mesin telah dipetakan memiliki potensi kontribusi pada upaya mitigasi dan adaptasi perubahan iklim di berbagai sektor (Rolnick et al., 2022). Potensi manfaat itu tidak otomatis berkelanjutan apabila jejak lingkungan dari sistem AI sendiri tidak dikelola. Para peneliti mengusulkan agar jejak air ditangani bersama jejak karbon dan disertai transparansi data operasional pusat data (Li et al., 2025). Pengembang model, operator pusat data, dan pembuat kebijakan perlu bekerja bersama agar pengembangan AI tidak mengorbankan ketersediaan air bersih.
KESIMPULAN
Hubungan antara AI dan air bersifat ganda. Di satu sisi, AI merupakan konsumen air yang sangat besar melalui pendinginan pusat data, pembangkitan listrik, dan rantai pasok manufaktur cip. Di sisi lain, AI dan pembelajaran mesin memiliki potensi besar sebagai alat bantu dalam pengelolaan sumber daya air, seperti pemodelan hidrologi, prediksi banjir, serta pemantauan kualitas air.
Tingkat konsumsi air dan efisiensi komputasi AI sangat bergantung pada lokasi geografis dan iklim lokal. Di wilayah beriklim tropis seperti Indonesia (khususnya pusat data di kawasan Jabodetabek dan Batam), beban pendinginan mekanis menjadi jauh lebih tinggi, yang berdampak pada konsumsi air yang besar serta peningkatan risiko keterancaman pasokan air baku dan penurunan tanah akibat ekstraksi air tanah.
Pengembangan AI yang pesat tidak dapat berkelanjutan jika penanganan dampaknya hanya berfokus pada jejak karbon. Jejak air (water footprint) harus diintegrasikan sebagai parameter utama dalam kebijakan keberlanjutan teknologi untuk mencegah terjadinya konflik pemanfaatan air antara pusat data dan kebutuhan mendasar masyarakat.
SARAN
- Bagi Pembuat Kebijakan dan Pemerintah: Pemerintah perlu menyusun regulasi tata ruang dan penetapan lokasi pusat data yang berbasis pada analisis daya dukung hidrologi lokal. Pembangunan pusat data baru sebaiknya diarahkan ke wilayah yang kaya akan pasokan air baku (seperti kawasan sekitar Sungai Mahakam di Kalimantan Timur) serta mewajibkan transparansi laporan jejak air operasional dari para pengembang teknologi.
- Bagi Operator Pusat Data dan Pengembang AI: Operator disarankan untuk mengadopsi teknologi pendinginan yang lebih hemat air (seperti sistem iklim tertutup atau pendinginan cair tingkat lanjut) dan menerapkan penjadwalan komputasi dinamis (dynamic workload scheduling) yang memindahkan proses pelatihan model berat ke waktu atau kawasan dengan efisiensi energi dan air tertinggi.
- Bagi Peneliti dan Akademisi: Diharapkan adanya riset lanjutan yang berfokus pada pengembangan algoritma AI yang ramah lingkungan (Green AI) serta integrasi pemodelan hidrologi presisi tinggi yang dapat membantu mengoptimalkan efisiensi penggunaan air dan energi pada fasilitas komputasi itu sendiri.
DAFTAR PUSTAKA
Ho, S. (2026, April 14). Southeast Asia’s data centres should be sited in more water-rich areas: Experts. Eco-Business. https://www.eco-business.com/news/southeast-asias-data-centres-should-be-sited-in-more-water-rich-areas-experts/
Li, P., Yang, J., Islam, M. A., & Ren, S. (2025). Making AI less “thirsty”: Uncovering and addressing the secret water footprint of AI models. Communications of the ACM. https://arxiv.org/abs/2304.03271
Nearing, G. S., Kratzert, F., Sampson, A. K., Pelissier, C. S., Klotz, D., Frame, J. M., Prieto, C., & Gupta, H. V. (2021). What role does hydrological science play in the age of machine learning? Water Resources Research, 57(3), Article e2020WR028091. https://doi.org/10.1029/2020WR028091
Rolnick, D., Donti, P. L., Kaack, L. H., Kochanski, K., Lacoste, A., Sankaran, K., Ross, A. S., Milojevic-Dupont, N., Jaques, N., Waldman-Brown, A., Luccioni, A. S., Maharaj, T., Sherwin, E. D., Mukkavilli, S. K., Kording, K. P., Gomes, C. P., Ng, A. Y., Hassabis, D., Platt, J. C., ... Bengio, Y. (2022). Tackling climate change with machine learning. ACM Computing Surveys, 55(2), Article 42. https://doi.org/10.1145/3485128
Shehabi, A., Smith, S. J., Hubbard, A., Newkirk, A., Lei, N., Siddik, M. A. B., Holecek, B., Koomey, J., Masanet, E., & Sartor, D. (2024). 2024 United States data center energy usage report. Lawrence Berkeley National Laboratory. https://doi.org/10.71468/P1WC7Q
Sit, M., Demiray, B. Z., Xiang, Z., Ewing, G. J., Sermet, Y., & Demir, I. (2020). A comprehensive review of deep learning applications in hydrology and water resources. Water Science and Technology, 82(12), 2635–2670. https://doi.org/10.2166/wst.2020.369
Tasyarani, N. M. (2026, April 8). Indonesia’s data centre boom raises alarm over water use. The Jakarta Post. https://asianews.network/?p=266935